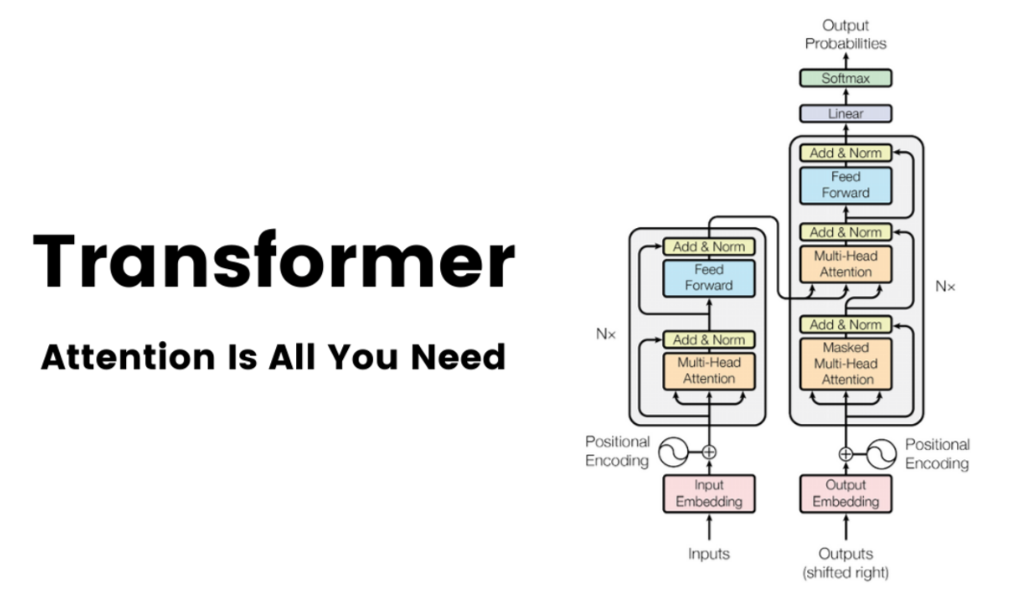
AI领域神一样的文章《Attention Is All You Need》在2017年问世,自此一改RNN的痛点,抛弃LSTM复杂的记忆机制,以纯矩阵运算的暴力美学拉开了人工智能领域的新篇章。在NLP系列博客中,我于最后一章简要地提了一下Transformer架构--事实上个人觉得,Transformer才是NLP重点的开端。本章博客将从注意力机制的复习开始,讲清楚注意力机制与自注意力机制的区别--其实你会发现它们并没有多大的区别,但仅是这一点点区别便催发了NLP生态的万千景象--再深入Encoder-Decoder的框架,了解多头注意力机制,以及位置编码技术,最后将这些部件结合起来组装成我们的变形金刚(Transformer)。本章笔记不会涉及Transformer在工程上的一些技术实现(比如十分重要的KV Cache),只集中于理论部分。
本系列博客主要围绕Agent相关技术--实际上许多相关技术目前并没有一个绝对的理论框架,比如Prompt、记忆等,都几乎是一些经验方法。Transformer在其中只属于一个背景知识的作用,在一些涉及模型内部的部分会提及--实际上,你没学Transformer只学了深度学习也可以懂。不过作为NLP的革命性技术,笔者认为还是应该给Transformer单开一章。后续等笔者将整个大模型与Agent的大体框架写完后,或许会考虑补充一些工程方面的内容。
要点:软性注意力机制、Encoder-Decoder框架、自注意力机制、多头注意力、位置编码、FFN、Mask、Add&Norm、Transformer